图片的核心是 Layout,视频的核心是 Event
当渲染能力被商品化以后,视频领域还剩下什么稀缺能力?
图片的核心是 Layout,视频的核心是 Event
视频不是一组更长的图片。
更准确地说,一段视频更像是一个世界程序运行之后,被摄像机观察到的执行轨迹。
我现在更愿意把视频写成:
Statet+1 = Eventt(Statet)
Video = Renderer(State0 … StateT)
其中:
- Layout 表达空间结构
- Assets 表达角色、商品、物体、声音和品牌素材
- Context 表达场景、风格、环境和其他持久条件
- Event 表达动作、对白、镜头运动、环境变化以及状态之间的因果转移
- Renderer 负责把状态轨迹渲染成最终像素与声音
如果说 Layout 是一个空间截面,那么 Event 就是状态沿时间轴发生的变化。甚至可以近似写成:Event ≈ ΔState / Δt。
这正是视频与图片最根本的差异:图片需要解决“什么在哪里”,视频还必须解决“接下来发生什么,以及为什么发生”。
2026 年,阿里 Wan-Streamer v0.3 的论文直接把这件事浓缩成一句话:Video = World + Event Stream。
论文中的 World 是场景、环境、角色身份、声音条件等持续存在的内容;Event Stream 则是人物行为、对白、镜头运动、声音和环境变化等沿时间发生的内容。
一段被录制的视频,是某个 Event Stream 在一个 World 中展开后的结果;实时交互视频,则是 Event Stream 根据外部输入在线产生。
如果说 Reve 押中 Layout,是在为图片寻找 HTML,那么 Wan-Streamer 把 Event Stream 提到中心,就是在为视频寻找 Runtime。
为什么过去强调首尾帧,而 Agent 必须重视 Event?
过去的视频模型推崇首尾帧,是渲染能力还不成熟时非常正确的工程选择。
首尾帧生成解决的是:
它本质上是时间轴上的 Inpainting。尾帧已经提前告诉模型人物最终站在哪里、物体最后是什么状态、镜头最终如何构图。模型不必预测事件的结果,只要寻找一条能够连接两个边界的合理轨迹。
换句话说,首尾帧把因果预测问题,降级成了条件插值问题。
而“首帧 + Event”解决的是:
这才进入 Causal Rollout 的问题。
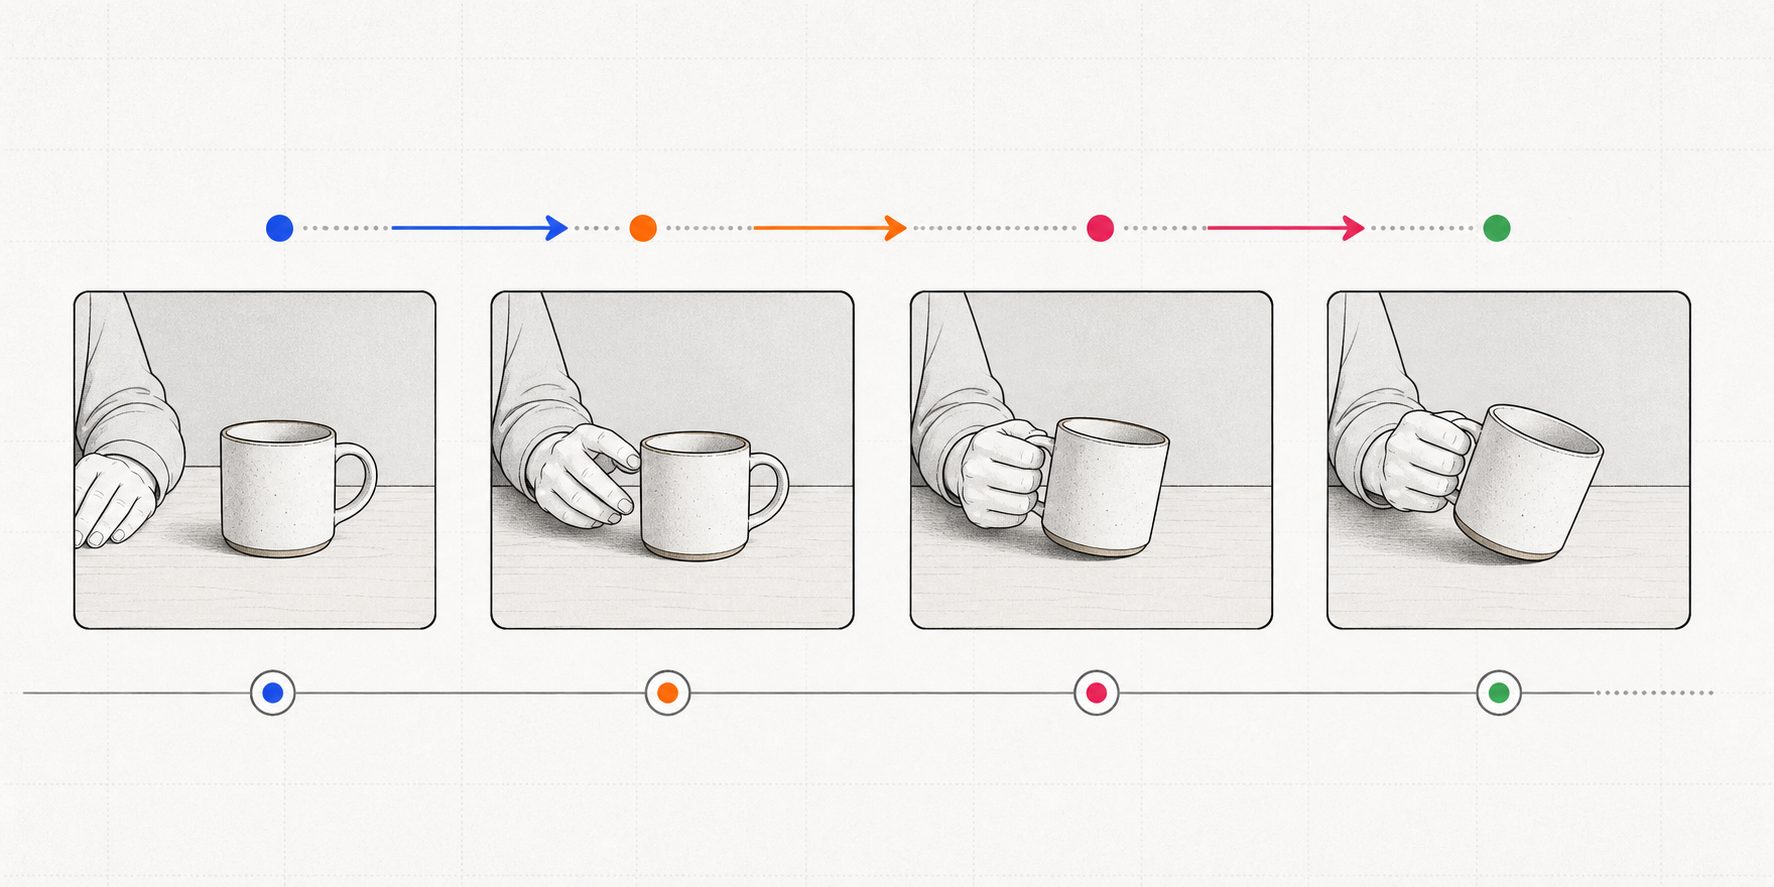
难点在于,同一个 Event 未必只有一个结果。“把杯子推下桌”可能导致杯子摔碎、弹起、被接住或者落在地毯上。首帧只是世界状态的可见投影,并没有告诉模型杯子的材质、桌面高度、地面软硬和场外人物的反应。
Event 要进入 Agent,不能只是一句自然语言标签,至少要接近一个可执行操作:
这就是 Event 与 Coding 的接口。代码是 State → Function → State;视频 Event 是 World State → Transition → World State。
首尾帧不会消失,但它的角色会改变。过去,尾帧是用户提供给模型的生成条件;未来,尾帧会成为 Agent 根据 Event Graph 编译出来的阶段目标、Checkpoint 或测试断言。
LLM 是叶脉,Diffusion 是叶片
视频模型可以被拆成两种能力。
一种是智能
- 理解用户意图
- 拆解故事和动作
- 保持角色、物体与空间关系
- 理解时间和因果
- 决定镜头与对白
- 发现错误并进行修改
另一种是渲染与审美
- 画面质量与人物表演
- 构图与镜头语言
- 光影、质感和风格
- 音频、情绪和品牌审美
它们更像一片叶子的两部分。LLM 和 Agent 是叶脉,负责把意图、结构和因果输送到每一个局部;Diffusion 是叶肉,负责让这些结构长成真实、连续、具有审美的像素。
要连接这两者,靠的不能只是一段自然语言 Prompt,还需要一种双方都能读写的中间语言:
没有这层中间表示,LLM 只能不断重写 Prompt,Diffusion 只能一次次重新抽卡。
有了这层中间表示,视频中的每个角色、商品、场景和事件才能被寻址:
- 修改商品,而不改变人物
- 修改一个动作,而不重做整条视频
- 更换受众,但复用原来的叙事结构
- 从某个状态重新运行,而不是回到第一帧
- 在失败的 Event 上局部修复,而不是重新生成全部内容
所以,Video Agent 如果只是“LLM 调用几次视频模型,再用 FFmpeg 拼起来”,仍然不够。它必须拥有世界状态,维护 Event Graph,并知道每次生成之后应该检查什么。
视频领域的 Ground Truth 在哪里?
很多人认为,Coding 有测试,视频只有审美,因此视频 Agent 不可能形成同样的自我改进闭环。
我认为,这个问题问错了层级。视频当然没有唯一正确的像素答案,但这不意味着它没有 Ground Truth。视频的 Ground Truth 不应该只在像素层寻找,而应该上移到 State 和 Event。
例如一条商品广告可以被自动检查:
- 指定商品是否始终是同一个资产
- 商品是否在第 3 秒被拿起,标签是否在第 5 秒转向镜头
- 人物身份、服装与左右手是否保持一致
- 对白是否由正确角色说出,口型、语音和动作是否时间对齐
- 品牌文字、价格和免责声明是否正确
- 是否满足时长、比例和平台规范
- Event 的后置条件是否成立
一条视频可以很好看,却没有完成任务;也可以只是低清草稿,却已经正确完成了所有事件。
因此,视频 Agent 的测试体系应该分成三层:
- 硬约束测试:资产、文字、动作、时序、合规是否正确。
- 状态与事件测试:因果、连续性、身份和后置条件是否成立。
- 业务 Reward:完播率、点击率、转化率、票房或用户偏好是否提高。
这里必须区分 Ground Truth 和 Reward。完播率、票房或内容分级,并不是某个镜头是否正确的 Ground Truth;它们是受到流量分发、题材、演员、用户群等大量变量影响的延迟 Reward。
就像代码测试通过,不代表产品一定有人使用;但没有测试通过,产品根本不应该上线。视频也需要先拥有自己的“单元测试”,才有资格继续优化审美和商业结果。
视频 Agent 最先落地的场景,不一定是电影
如果视频只是一次性消费的 MP4,它确实很难像代码一样规模化。但如果视频可以表示成:
并且其中每一个状态都可以修改,事情就完全不同了。同一个 Event Graph 可以:
- 替换不同商品,面向不同人群和使用场景
- 改写不同语言和口播
- 自动适配横屏、竖屏和不同时长
- 批量生成数百个版本
- 自动验收后进入投放系统
- 根据转化结果继续优化下一轮事件设计
所以我认为,视频 Agent 最早建立起类似 Coding 的商业闭环,不一定是在“替导演生成一部电影”,而更可能是在可参数化、可批量验收的商业视频生产中。
例如电商广告、效果素材、本地化内容、商品演示、培训视频和操作说明。这些场景具备 Coding 成功时相似的条件:
- 需求真实且高频,有明确预算和付费者
- 输入资产相对结构化,结果存在大量硬约束
- 可以自动生成多个版本
- 可以用投放和业务结果形成反馈
影视和短剧当然也会被改变,但它们的审美目标更加开放,反馈噪声更大。这类闭环可能先在商业视频中建立,再向更长、更自由的内容生产扩张。
内容生产与世界模型,最终会在 Event 汇合
如果目标是内容生产,视频模型的 Coding 类比不是“一条更漂亮的视频”,而是把创意意图稳定地变成可交付、可修改、可复用、可批量验收的视频资产。
如果目标是世界模型,重点则不是审美,而是一个动作发生以后,世界能否持续、正确、可预测地响应。
二者看起来属于不同产业,底层却共享同一个中间层:State + Event。
内容 Agent 使用它来编排故事、镜头和商业信息;世界模型使用它来模拟动作、环境和未来结果。前者更重视 Renderer,后者更重视 Dynamics,但它们都需要:
- 持续存在的世界状态
- 能够改变状态的事件
- 对事件结果的预测
- 对前置与后置条件的验证
- 失败后的重新规划
所以,视频 Agent 的完整闭环应该是:
Event 决定发生什么。关键帧钉住阶段结果。Diffusion 决定它看起来怎样。Verifier 判断这次执行是否完成了任务。
我对 Video Agent 的预测
如果 MiniMax H3 正在把单次视频生成推向商品化,那么视频领域的价值会和 Chatbot 之后的 LLM 一样,继续向上迁移:
- 从模型迁移到 Agent
- 从像素迁移到结构
- 从一次生成迁移到持续执行
- 从 Prompt 迁移到 State 和 Event
因此,我现在对 Video Agent 的 Bet 可以浓缩成一句话:
因此,竞争焦点未必还会是每个月榜单第一的 Renderer,而会逐步转向 Event 表示、世界状态、意图编译器、视频 Runtime、State/Event Verifier,以及真实的生产与反馈数据。
单次视频生成会成为 Video Agent 调用的一项能力。更大的产品价值,会落在工具选择、事件组织、结果验证,以及如何把一次创意稳定转化成一整套可交付资产上。
YUKI PENG · AI PRODUCT / RESEARCH / WRITING