视频模型的下一个 Bet
Chat 之后是 Coding,单次视频生成之后是什么?
最近读到一篇 36 氪文章——《智谱,害怕成为下一个 MiniMax》。
文章提到,2025 年初,当行业还在讨论 DeepSeek 带来的推理革命时,智谱已经开始把研发重心从通用聊天转向 Coding。
唐杰后来把判断概括为:“DeepSeek R1 出现之后,Chat 范式已经基本结束。”下一代模型的竞争力,不再只看谁聊天更像人,而看谁能真正完成工作。
现在回头看,智谱押中的那个 Bet,正是 Coding。
这也让我开始重新思考一个问题:
如果 Coding 是语言模型在 Chatbot 之后找到的下一条价值曲线,那么视频模型的下一个 Bet 是什么?
我的答案逐渐变得清晰:
不是生成一条更漂亮的视频,而是让视频成为一种可执行、可修改、可验证、可批量生产的世界程序。
而这个世界程序的核心中间表示,不是更长的 Prompt,也不只是 Layout,而是:
初始世界状态 + 事件流
这个答案分成上下两篇展开:上篇讲它从哪里来,下篇讲它意味着什么。
一个故事结束,不代表需求消失
“Chatbot 的故事结束了”,并不是说人们不再使用聊天机器人。它所指的是:“通用聊天界面 + 通用模型能力”不再具有足够的稀缺性和溢价。
DeepSeek 所划下的,是一条能力商品化的斩杀线。当一种能力同时满足几个条件:
- 质量已经足够可用
- 供应者迅速增加
- 调用价格持续下降
- 产品接口高度标准化
它就会从“值得单独讲述的商业故事”,变成所有产品都可以调用的基础设施。
对话仍然重要,但很难再仅凭“我们有一个更好的 Chatbot”成立一家高估值公司。
所以,Bet 不是预测哪个模型下个月登顶。Bet 是对“下一项不会立刻被商品化的稀缺能力”做出资源承诺。
更完整地说:Bet 是在高度不确定的竞争中,把有限的人力、算力和组织注意力,集中投向一个高潜力、可验证、能够形成规模化回报的假设。
它押的不是今天最有价值的东西,而是明天价值变化率最大的东西。
为什么是 Coding?
Coding 表面上是“让模型写代码”,但关键不只在写代码本身,还在后面的三层。
第一,Coding 是最早拥有 Ground Truth 的开放领域
代码能不能运行、测试是否通过、编译有没有报错,是相对客观的。模型第一次可以形成完整闭环:
Chatbot 的回答往往没有唯一正确答案,代码却可以被环境直接检验。
第二,代码是可执行的推理
Chatbot 输出的是一段话;Coding Agent 输出的是一次真实的状态改变:修改文件、运行程序、操作数据库、部署服务。
从这个意义上说,Coding 并不是一个普通垂直领域,而是 LLM 从“会说”走向“会做”的第一个训练场。
第三,Coding 是可以规模化交付的产品
它有高频需求,有明确的付费者,有可以量化的 ROI,也有持续回流的真实任务轨迹。产品不需要为每个客户重新做一遍项目,而是可以在同一个 Agent 系统中不断复用。
因此,Coding 押中的不只是代码,而是:高频刚需 × 可执行环境 × 自动验证 × 数据飞轮。
这四件事构成了 Agent 商业化最重要的闭环。
真正的 Bet,往往是对“中间层”的判断
生成模型的竞争异常激烈。根据 Artificial Analysis 的 2024 年度报告,截至 2024 年 12 月,图像榜单前五名全部发布于当年第三季度之后。Recraft V3、FLUX 1.1 Pro、FLUX.1 Pro 等模型在短时间内连续改写排名。
这说明,单次生成质量的领先很难形成长期壁垒。
在这类竞争里,值得押的往往不是“比别人多生成一点细节”,而是提前判断:下一代模型应该用什么结构思考、用什么接口工作、从哪里获得反馈。
历史上至少有三类成功的 Bet:
- DiT 是架构 Bet:押注 Transformer 可以成为可扩展的视觉生成骨干。
- Coding 是反馈 Bet:押注可执行环境和自动测试可以持续提高模型能力。
- Layout 是中间表示 Bet:押注自然语言不足以精确表达视觉空间。
Reve 对 Layout 的判断尤其值得关注。自然语言虽然表达能力很强,却天然存在空间歧义。于是他们不再让语言模型只写一段更长的 Prompt,而是生成一个结构化 Layout:每个元素都有位置、面积、局部描述、颜色和引用素材。
Layout 像 HTML 之于网页、SVG 之于矢量图,让图像中的每个元素第一次变得可寻址、可修改、可复用。
这背后有一个很简单的第一性原理:图片只有空间,没有时间。一张图片中最重要的全局变量,是不同内容如何占据画面。因此,图片最值得被结构化的不是所有视觉细节,而是构图。
Layout 决定什么东西在哪里,Diffusion 决定它最终长什么样。
MiniMax H3 正在逼近视频生成的“DeepSeek 时刻”
在我看来,MiniMax H3 对单次视频生成行业的意义,正在接近 DeepSeek 对 Chatbot 的意义。
H3 将过去分散的文生视频、图生视频、首尾帧、主体参考、动作参考、视频编辑、音频生成和多镜头生成,放进了一个通用多模态生成系统,并进一步开放模型权重。
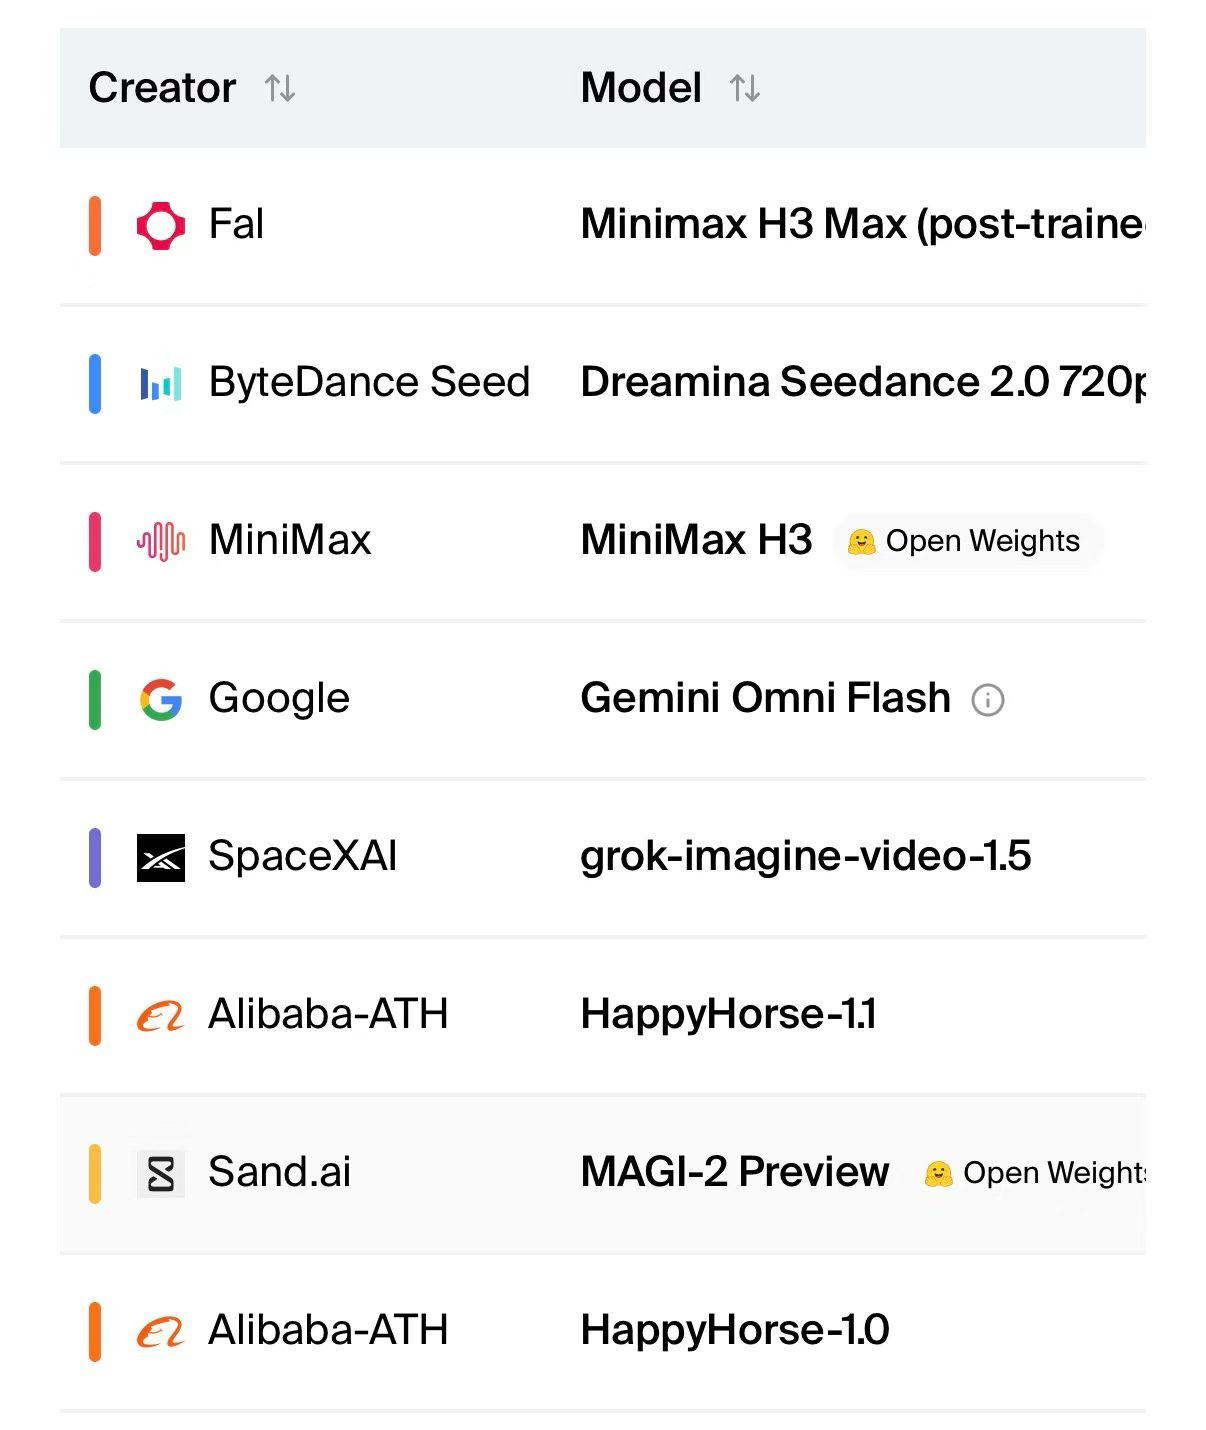
它不一定意味着视频模型竞争已经结束,但它发出了一个非常明确的信号:当高质量、带音频、多参考、可编辑的视频生成逐渐成为通用模型能力,仅仅提供“一次生成一条视频”将越来越难形成独立壁垒。
这里需要说明的是,开放权重不等于完整工作流的每一层都可以离线复现。H3 的公开模型与部分托管模块仍需分开理解,具体边界可参照其公开模型卡。
视频仍然会被大量生成,就像 Chatbot 仍然会被大量使用。但单次出片会逐渐从产品,退化为一个 Tool Call。
因此,现在更应该问的,不是哪家公司下个月能生成最惊艳的 Demo,而是:
当渲染能力被商品化以后,视频领域还剩下什么稀缺能力?
YUKI PENG · AI PRODUCT / RESEARCH / WRITING